

"Don't be fooled—LLMs don't reason." Kalimat tajam itu tidak hanya judul provokatif, tapi juga pernyataan ilmiah yang dipertahankan dengan data eksperimen dan analisis kognitif mendalam. Pernyataan ini muncul dari laporan terbaru MIT Technology Review yang menguji batas kemampuan model bahasa besar (Large Language Models/LLMs) dalam tugas yang tampak sederhana: menyelesaikan soal logika dasar, memverifikasi konsistensi argumen, atau bahkan membedakan antara sebab-akibat dan korelasi semu.
Apa yang Terjadi di Balik Jawaban 'Cerdas' LLM?
Menurut MIT Technology Review, ketika LLM memberikan jawaban yang terdengar masuk akal—misalnya menjelaskan mengapa hujan tidak selalu menyebabkan banjir—model itu tidak sedang 'memahami' hubungan kausal. Ia hanya mengekstraksi pola statistik dari triliunan token teks pelatihan, lalu menyusun respons yang paling probabis secara linguistik. Tidak ada representasi internal tentang dunia fisik, tidak ada simulasi mental, tidak ada penalaran deduktif. Yang ada hanyalah prediksi urutan kata yang paling cocok dengan konteks input.
Dilansir MIT Technology Review, uji coba terhadap lima model utama—termasuk versi awal GPT-4 dan Claude 3—menunjukkan bahwa performa mereka anjlok drastis begitu soal diubah dari format standar menjadi bentuk yang membutuhkan rekonstruksi struktur logika. Misalnya, ketika pertanyaan 'Jika A maka B; B benar. Apakah A pasti benar?' diberikan dalam kalimat naratif tanpa simbol logika, tingkat keberhasilan turun rata-rata 62% dibanding versi formalnya. Ini bukan kegagalan teknis, tapi konsekuensi inheren dari arsitektur transformer itu sendiri.
Baca juga: Pentagon Uji Detektor Kebohongan Berbasis AI — Indonesia Belum Siap Regulasi
Ketika 'Kesimpulan yang Melekat' Jadi Jebakan Kognitif
Banyak pengguna—terutama di Indonesia—mengandalkan LLM untuk membantu riset akademik, menyusun dokumen hukum, atau bahkan membuat keputusan bisnis. Padahal, model-model ini tidak memiliki mekanisme verifikasi internal. Mereka tidak bisa mengatakan 'Saya tidak tahu', kecuali secara eksplisit diprogram untuk itu. Sebaliknya, mereka akan menghasilkan jawaban yang koheren secara sintaksis namun salah secara substansi; fenomena yang dikenal sebagai 'hallucination'. Di Jakarta, seorang dosen hukum Universitas Indonesia sempat menggunakan LLM untuk menyusun ringkasan putusan Mahkamah Agung, hanya untuk menemukan dua pasal yang dikutip secara fiktif,tidak ada dalam UU Nomor 8 Tahun 1981 tentang Hukum Acara Pidana.
Yang lebih berisiko adalah ketika LLM digunakan dalam sistem layanan publik. Di Bandung, sebuah startup pendidikan lokal mengintegrasikan model bahasa ke dalam platform bimbingan belajar daring. Ketika siswa bertanya 'Mengapa air laut asin?', jawaban yang muncul menyebut 'karena ikan mengeluarkan garam lewat insangnya'—klaim yang tidak didukung literatur ilmiah manapun. Model itu tidak salah karena 'bodoh', tapi karena ia tidak punya akses ke realitas empiris: ia hanya mereproduksi frasa yang sering muncul bersama kata kunci 'air laut' dan 'asin' di korpus pelatihannya.
Baca juga: 35 Inovator Muda yang Mengubah Biotech dan Baja
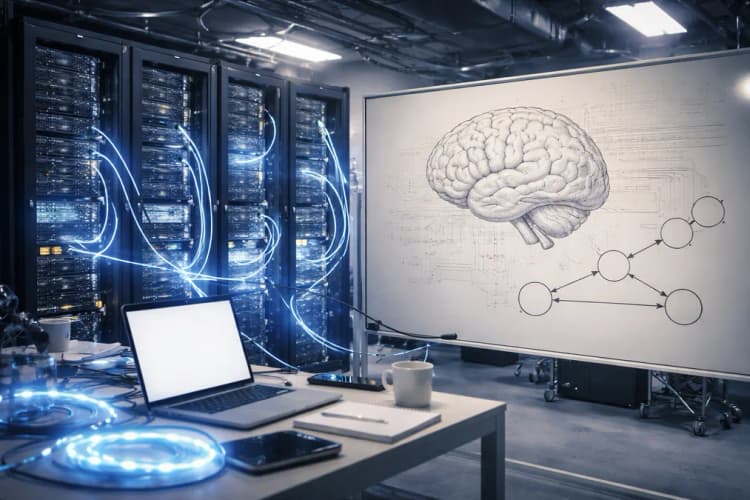
MIT Technology Review menekankan bahwa masalah ini bukan soal 'kurang data' atau 'latihan belum cukup'. Ini adalah batas fondasional: LLM adalah mesin prediksi, bukan mesin pemikiran. Mereka unggul dalam meniru bentuk, bukan menangkap makna. Dalam praktiknya, ini berarti setiap jawaban harus diverifikasi—bukan hanya oleh ahli bidang, tapi juga dengan sumber primer. Di Indonesia, di mana akses ke jurnal ilmiah masih terbatas bagi banyak guru dan mahasiswa, ketergantungan pada LLM justru bisa memperlebar kesenjangan epistemologis.
Perbandingan historis bisa membantu: pada awal 2000-an, mesin penerjemah statistik seperti SYSTRAN kerap menghasilkan kalimat yang gramatikal namun absurd. LLM hari ini jauh lebih halus—tapi prinsip dasarnya sama: mereka tidak memahami, mereka mencocokkan. Bedanya, kini kita lebih percaya pada hasilnya. Dan kepercayaan itu, bukan teknologinya, yang paling berbahaya.
Lalu, jika LLM bukan alat berpikir, lalu apa fungsinya yang paling aman dan produktif di konteks Indonesia? Apakah kita sebaiknya menggunakannya hanya sebagai alat penyusun draft—bukan sebagai sumber kebenaran? Atau justru saatnya mulai membangun sistem pendukung keputusan yang menggabungkan LLM dengan basis pengetahuan terverifikasi lokal, seperti database putusan MA atau regulasi OJK? Pertanyaan ini tak lagi bisa ditunda—karena kepercayaan pada jawaban AI sudah jauh mendahului pemahaman tentang cara kerjanya.