

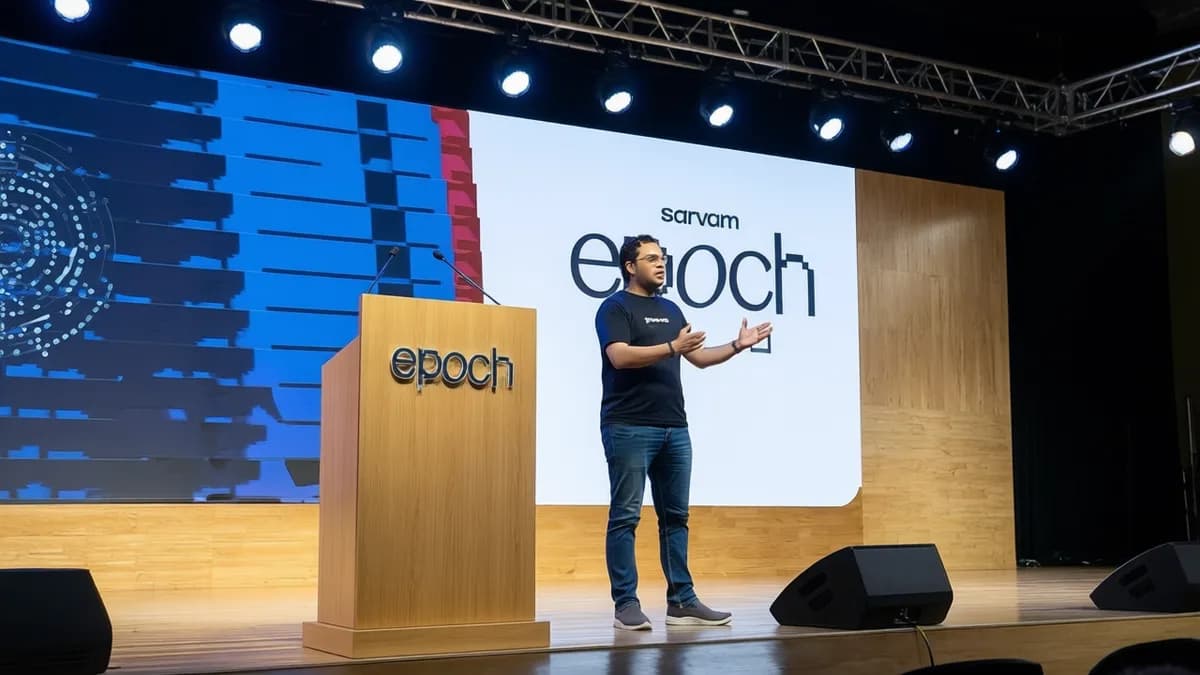
Di sebuah ruang kerja kecil di Bengaluru, seorang insinyur data sedang menguji ulang prompt dalam bahasa Kannada untuk sistem penilaian kredit mikro. Ia bukan menggunakan OpenAI atau Anthropic, melainkan model lokal bernama Sarvam-7B. Responsnya muncul dalam 1,2 detik — cukup cepat untuk skenario lapangan, dan lebih murah dari layanan cloud global. Ini bukan eksperimen akademis. Ini adalah uji coba pertama Sarvam AI di luar lingkaran internal, dan salah satu sinyal awal bahwa startup ini serius membangun fondasi teknologi AI yang benar-benar berakar di India.
Token Consumption tidak hanya Angka, tapi juga Indikator Kedaulatan Teknologi
Sarvam AI tidak mengejar popularitas model bahasa besar (LLM) semata. Strategi intinya jauh lebih teknis dan strategis: menguasai 'AI-token consumption' di India — yaitu volume token yang dikonsumsi oleh aplikasi lokal saat menjalankan inferensi, fine-tuning, atau RAG. Menurut TechInAsia, angka ini diperkirakan tumbuh lebih dari tiga kali lipat antara 2023 dan 2025, didorong oleh adopsi pemerintah dan UMKM. Namun, lebih dari 85% konsumsi token saat ini masih dialihkan ke pusat data AS dan Singapura, karena keterbatasan infrastruktur inferensi domestik dan harga komputasi yang belum kompetitif.
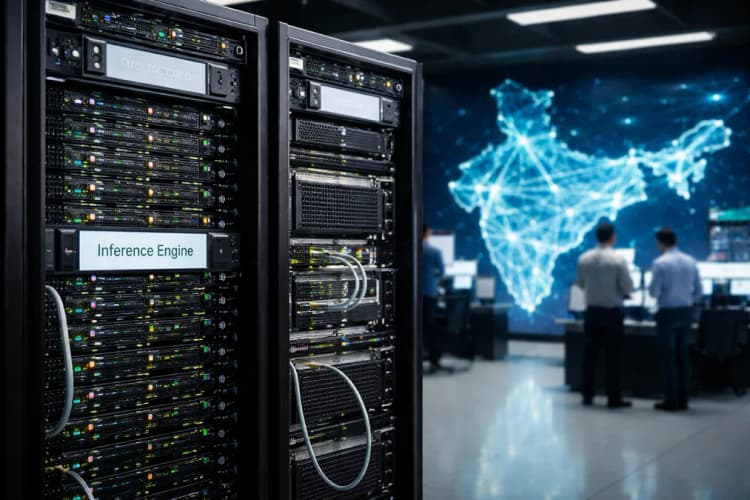
Sarvam membalik logika itu. Mereka tidak hanya merilis model bahasa multilingual — tetapi juga membangun 'Sarvam Inference Engine', platform manajemen token yang bisa di-deploy di data center lokal, termasuk di bawah aturan sovereign cloud milik National Informatics Centre (NIC). Platform ini memungkinkan pelanggan menghitung biaya per token secara transparan, memantau latensi per bahasa, dan bahkan mengoptimalkan penggunaan token lewat kompresi konteks otomatis. Ini bukan soal efisiensi teknis belaka; ini soal mengubah token dari komoditas abstrak menjadi unit pengukuran kedaulatan teknologi.
Baca juga: LG Uplus dan OptAI Uji Token AI untuk Efisiensi Layanan
Beda dengan Perusahaan Global: Infrastruktur Dibangun Sejak Hari Pertama
Perbedaan paling nyata antara Sarvam dan banyak startup AI lain di Asia adalah urutan prioritas pembangunan. Sementara sebagian besar fokus pada model dulu, lalu mencari cara mengoperasikannya, Sarvam justru memulai dari infrastruktur inferensi — bahkan sebelum model pertamanya dirilis. Mereka bekerja sama dengan perusahaan chip India seperti Saankhya Labs untuk mengoptimalkan model pada arsitektur RISC-V, dan mengembangkan compiler khusus agar model berjalan efisien di GPU lokal berbasis AMD MI300X yang diimpor melalui jalur khusus pemerintah.
Tidak ada klaim 'end-to-end' tanpa dasar. Sarvam telah mengoperasikan cluster inferensi di Hyderabad dan Pune sejak Q3 2023, dengan kapasitas total 4.200 GPU-equivalent. Yang penting: semua cluster ini terhubung langsung ke jaringan fiber optik nasional, bukan melalui gateway internasional. Hasilnya, latency rata-rata untuk permintaan dalam bahasa Hindi turun dari 3,8 detik (saat pakai API asing) menjadi 0,9 detik — angka yang membuat aplikasi real-time seperti asisten layanan publik atau sistem pendidikan interaktif benar-benar layak digunakan di daerah pedesaan.
Baca juga: Bolttech dan Bold Penguin Bentuk Aliansi Asuransi Global Berbasis AI
Teknologi ini juga memengaruhi desain model. Sarvam-7B bukan sekadar versi kecil dari Llama atau Gemma. Arsitekturnya dirancang khusus untuk 'token frugality': setiap layer dilatih agar menghasilkan representasi lebih padat, sehingga untuk tugas spesifik seperti ekstraksi entitas dari dokumen resmi dalam bahasa Tamil, ia butuh 42% token lebih sedikit dibanding model sekelas dari penyedia global — tanpa mengorbankan akurasi. Ini bukan optimasi marginal. Ini adalah filosofi desain yang lahir dari keterbatasan nyata: bandwidth terbatas, listrik tidak stabil, dan biaya transfer data lintas batas yang tinggi.
Bagi Indonesia, cerita Sarvam bukan sekadar studi kasus. Ini adalah peringatan halus: ketika negara dengan ekosistem digital lebih matang dan regulasi data yang lebih ketat pun masih kesulitan mengurangi ketergantungan pada infrastruktur asing, maka upaya seperti Kominfo's AI Readiness Framework atau inisiatif sovereign cloud Telkom harus mulai memasukkan 'token efficiency' sebagai metrik kinerja utama — bukan hanya jumlah model yang dilatih atau jumlah startup yang didanai.
Dilansir TechInAsia, pendekatan Sarvam telah menarik minat enam departemen pemerintah India, termasuk Kementerian Pendidikan dan Kementerian Kesehatan, untuk integrasi sistem layanan publik. Tidak ada janji revolusi. Hanya komitmen bertahap: membangun satu token, satu server, satu bahasa pada satu waktu. Dan seperti kata co-founder Sarvam AI, Pranav Chaturvedi, dalam wawancara terbarunya: "Kami tidak ingin menjadi pemain global yang kebetulan berbasis di India. Kami ingin menjadi bagian dari infrastruktur yang membuat India bisa berbicara, berpikir, dan memutuskan dalam bahasanya sendiri — tanpa harus minta izin dari pusat data di Virginia."